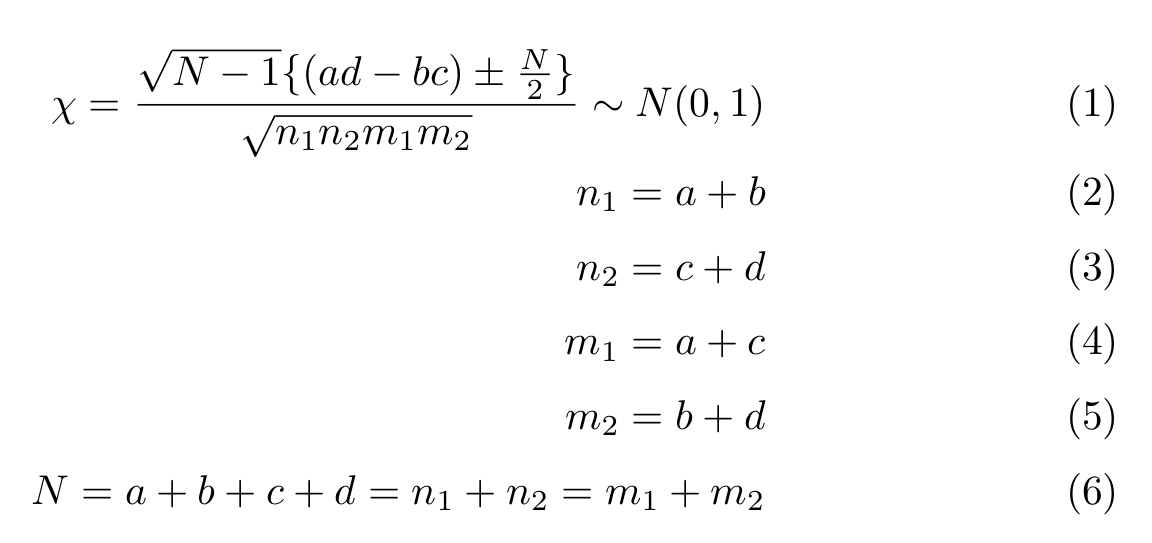ラベル 生物統計学 の投稿を表示しています。 すべての投稿を表示

第一種の誤りとは

第一種の誤りとは

「帰無仮説が真のとき、これを棄却してしまう」

誤りのことです。

そして、第一種の誤りを犯す確率をαとして、有意水準または危険率と一般に呼びます。

第一種の誤りについてもう少し直感的に理解するには、条件付き確率を扱っていることを認識する必要があります。

すなわち、危険率とは


  1. 帰無仮説が真のとき(こういう条件の下だと)
  2. これを棄却してしまう確率
ということなのです。
ですので、あくまで「帰無仮説が正しいとき」を想定しなければ、危険率αのニュアンスはわからないのです。

正規分布からのサンプルの平均値の検定を題材にして、危険率αとはどのようなものなのかということをシミュレーションを通じて考えてみたいと思います。


今、平均値μ、分散σ^2/μの正規分布(標準正規分布)から、サンプリング(n)を行い、標本平均の分布について考えたいと思います。

一般に平均μ、分散σ^2の正規分布から抽出されたサンプル(n)の平均値の分布は平均値μ、分散σ^2/nの正規分布に従うとされます。
サンプルの平均値を標準化して、
を考えます。Zは標準正規分布に従います。

それでは、平均値12、分散9の正規分布の集団からn=5のサンプリングを行い、その平均値の分布について計算してみます。

一回の試行は以下のようにして行うことができます。
> rnorm(mean=12, sd=3, n=5)
[1] 15.039414  9.264087 11.036560 16.033761 11.038038

Zの値は以下のようにして計算します。
> (mean(rnorm(mean=12, sd=3, n=5) - 12)/(3/sqrt(5)))
[1] 13.86206

ところで、標準正規分布を描写すると以下のようになります。
> curve(dnorm(x), -3, 3)
ここで、上側確率、下側確率を計算してグラフに記入
> qnorm(0.025)
[1] -1.959964
> qnorm(0.975)
[1] 1.959964

> abline(v=qnorm(0.025), col="red")
> abline(v=qnorm(0.975), col="red")
それでは今回想定している平均値12、分散9の正規分布の集団からn=5のサンプリングを繰り返し(300回)行い、その都度Z値を計算しています。これらのZ値のうち、上側下側合わせて5%の区間にどの程度入ってくるか調べます。

curve(dnorm(x), -3, 3)
abline(v=qnorm(0.025), col="green")
abline(v=qnorm(0.975), col="green")
for(i in 1 : 100){
abline(v=(mean(rnorm(mean=12, sd=3, n=5) - 12)/(3/sqrt(5))), col = "magenta")
}
確かに、このように繰り返し平均値をもとめていると、
「帰無仮説は正しい」
のにも関わらず、一定の割合でサンプルの平均値は5%以下の確率で生じるとされる区間に入ってきてしまいます。

従って、ある検定を行いたいと考えたときに、サンプルの統計量が偶然には起こりそうにも無い値であったとしても、帰無仮説が誤っている可能性の他に、危険率αの確率で帰無仮説が正しい場合にも同様の統計量が計算される可能性があるといえるのです。

【参考文献】
山田剛史ほか『Rによるやさしい統計学』オーム社 2008 109-119pp

第一種の誤りとは ー危険率α=5%の意味ー


第一種の誤りとは

「帰無仮説が真のとき、これを棄却してしまう」

誤りのことです。

そして、第一種の誤りを犯す確率をαとして、有意水準または危険率と一般に呼びます。

第一種の誤りについてもう少し直感的に理解するには、条件付き確率を扱っていることを認識する必要があります。

すなわち、危険率とは


  1. 帰無仮説が真のとき(こういう条件の下だと)
  2. これを棄却してしまう確率
ということなのです。
ですので、あくまで「帰無仮説が正しいとき」を想定しなければ、危険率αのニュアンスはわからないのです。

正規分布からのサンプルの平均値の検定を題材にして、危険率αとはどのようなものなのかということをシミュレーションを通じて考えてみたいと思います。


今、平均値μ、分散σ^2/μの正規分布(標準正規分布)から、サンプリング(n)を行い、標本平均の分布について考えたいと思います。

一般に平均μ、分散σ^2の正規分布から抽出されたサンプル(n)の平均値の分布は平均値μ、分散σ^2/nの正規分布に従うとされます。
サンプルの平均値を標準化して、


を考えます。Zは標準正規分布に従います。

それでは、平均値12、分散9の正規分布の集団からn=5のサンプリングを行い、その平均値の分布について計算してみます。

一回の試行は以下のようにして行うことができます。
> rnorm(mean=12, sd=3, n=5)
[1] 15.039414  9.264087 11.036560 16.033761 11.038038

Zの値は以下のようにして計算します。
> (mean(rnorm(mean=12, sd=3, n=5) - 12)/(3/sqrt(5)))
[1] 13.86206

ところで、標準正規分布を描写すると以下のようになります。
> curve(dnorm(x), -3, 3)
ここで、上側確率、下側確率を計算してグラフに記入
> qnorm(0.025)
[1] -1.959964
> qnorm(0.975)
[1] 1.959964

> abline(v=qnorm(0.025), col="red")
> abline(v=qnorm(0.975), col="red")
それでは今回想定している平均値12、分散9の正規分布の集団からn=5のサンプリングを繰り返し(300回)行い、その都度Z値を計算しています。これらのZ値のうち、上側下側合わせて5%の区間にどの程度入ってくるか調べます。

> curve(dnorm(x), -3, 3)
> abline(v=qnorm(0.025), col="green")
> abline(v=qnorm(0.975), col="green")
> for(i in 1 : 100){
+ abline(v=(mean(rnorm(mean=12, sd=3, n=5) - 12)/(3/sqrt(5))), col = "magenta")
+ }
確かに、このように繰り返し平均値をもとめていると、
「帰無仮説は正しい」
のにも関わらず、一定の割合でサンプルの平均値は5%以下の確率で生じるとされる区間に入ってきてしまいます。

従って、ある検定を行いたいと考えたときに、サンプルの統計量が偶然には起こりそうにも無い値であったとしても、帰無仮説が誤っている可能性の他に、危険率αの確率で帰無仮説が正しい場合にも同様の統計量が計算される可能性があるといえるのです。

【参考文献】
山田剛史ほか『Rによるやさしい統計学』オーム社 2008 109-119pp

統計学的検定の根本的な概念

統計学的検定の根本的な概念は

母集団から抽出したデータから計算した統計量が、次のいずれに属するかを検討することだと思います。


  1. 偶然誤差の範囲にある(それくらいのばらつきは生じても不思議ではない)
  2. 偶然誤差の範囲を逸脱している(きっと想定した母集団モデルから逸脱させる何か、すなわち要因が働いているはずである)
以上のように考えると、統計学的検定の意味が少しずつ見えてくる気がします。
成書を読むと、1,2と同様の内容が必ず"さらっと"書かれていることに気がつきます。

Rを用いてdot plotを描写

Rを用いてdot plotを描写する方法を勉強しました。
dot plotには平均値と標準偏差を同時に記述することが多いので、今回もその慣例に従いました。

参考にさせていたいたのは下のリンクです。

http://minato.sip21c.org/swtips/MedicalStat-Rev.pdf

まずは、以下のデータをEXELで用意して、tab区切り形式で保存します。

あとはRを開いて以下のコマンドを実行すればよいです。

$ R


#データの読み込み
> dat <- read.table("body_height.txt", header=T)
> dat <- as.data.frame(dat)

> dat
   Male Sex
1   170   1
2   175   1
3   181   1
4   176   1
5   167   1
6   180   1
7   156   2
8   150   2
9   153   2
10  148   2
11  157   2
12  149   2

#Sex列を要因(factor)にする
> dat$Sex <- as.factor(dat$Sex)
> levels(dat$Sex) <- c('M','F')

> dat
   Male Sex
1   170   M
2   175   M
3   181   M
4   176   M
5   167   M
6   180   M
7   156   F
8   150   F
9   153   F
10  148   F
11  157   F
12  149   F

#各列名単独で列の要素にアクセスできるようにする
> attach(dat)


#平均値、標準偏差を計算
> mean <- tapply(Height,Sex,mean)
> sd <- tapply(Height,Sex,sd)
> is <- c(1,2)+0.15


#ドットプロットを描写
> stripchart(dat$Height~Sex,method="jitter",vert=T,ylab="body height(cm)") 
> points(is,mean,pch=18)
> arrows(is,mean-sd,is,mean+sd,code=3,angle=90,length=.1)


勝率と二項検定


サッカーのあるチームAがあるチームに対して、年間を通じて、Bチームと30試合を行い25勝5敗だったとします。
このデータから、チームAはチームBより強いと言えるでしょうか。
言い換えると、チームAのチームBに対する真の勝率は5割以上なのでしょうか。それとも、25勝5敗は誤差の範囲で勝ち越しているだけなのでしょうか。
この問題を解くには、二項検定という手法が用いられます。コインの裏表の出る確率の検定のときにも用いられる手法です。

#勝率が5割だったとした時の、勝利数の確率分布を描写する
> win <- 0:30
> plot(dbinom(win, 30, 0.5), type="h", xlab-"number of win")


#累積分布関数を描写する
> plot(pbinom(win, 30, 0.5), type="h", xlab="number of win")
#95%の水準に赤線を引く
> abline(h=0.95, col="red")
#5%の危険率で二項検定を行う
#方法1
> 1 - pbinom(25, 30, 0.5)
[1] 2.973806e-05

#方法2
> pbinom(25, 30, 0.5, lower.tail=FALSE)
[1] 2.973806e-05

> pbinom(25, 30, 0.5, lower.tail=FALSE) < 0.05
[1] TRUE
> pbinom(25, 30, 0.5, lower.tail=FALSE) < 0.01
[1] TRUE

> binom.test(25,30, 0.5)

 Exact binomial test

data: 25 and 30 
number of successes = 25, number of trials = 30, p-value = 0.0003249
alternative hypothesis: true probability of success is not equal to 0.5 
95 percent confidence interval:
 0.6527883 0.9435783 
sample estimates:
probability of success 
             0.8333333 

以上の計算結果から、チームAのチームBに対する勝率は有意に50%よりも大きいことが言えます。また、その信頼区間は0.65以上0.95以下です。

今回行った計算方法は、帰無仮説であるp=0.5を他の値に変更することによって、二項分布に従う様々な現象(打率、くじ引き etc)を説明することができます。

【参考文献】
山田剛史ほか『Rによるやさしい統計学』オーム社 2008 第12章

重回帰分析におけるモデルの検討


重回帰分析の手法について分子生物学的な事例をもとにして考えてみます。
ある時刻の遺伝子Mの発現量exp_mが、一時間前の遺伝子n及び遺伝子lの発現量(それぞれexp_n, exp_l)によりどのよう説明されるかというモデルを立てます。
具体的には、


というモデルを想定します。
aを切片、b_1、b_2を偏回帰係数、eを残差と呼びます。
それでは、Rを用いて重回帰分析を行ってみます。

#データの入力
> exp_m <- c(45, 46, 47, 57, 78, 89, 99, 89, 101, 108)
> exp_n <- c(102, 106, 109, 120, 124, 130, 146, 178, 190, 196)
> exp_l <- c(56, 57, 58, 50, 52, 61, 43, 63, 64, 60)

#exp_mを目的変数、exp_n, exp_lを説明変数として重回帰分析を行う
> summary(lm(exp_m~exp_n+exp_l))

Call:
lm(formula = exp_m ~ exp_n + exp_l)

Residuals:
    Min 1Q Median 3Q Max 
-11.530 -5.954 -3.900 3.842 24.637 

Coefficients:
                       Estimate   Std. Error     t value    Pr(>|t|)    
(Intercept)        36.3470      34.7881      1.045    0.330842    
exp_n                0.6858         0.1221     5.618     0.000801 ***
exp_l                -1.0022         0.6710    -1.494     0.178918    
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1 

Residual standard error: 11.91 on 7 degrees of freedom
Multiple R-squared: 0.822,Adjusted R-squared: 0.7712 
F-statistic: 16.16 on 2 and 7 DF, p-value: 0.002379 

exp_nのp値が有意となっているということは、冒頭の式のb_1が有意に0よりも大きい値であるということができます。また、exp_nを用いれば、各値の全体平均からのばらつきを有意に説明するとも言い換えることができます(ANOVAの考え方と同じです)。一方で、exp_lのp値は有意ではありませんでした。
R-squaredとは、決定係数と呼ばれ、「説明変数を用いてどの程度、目的変数の分散を説明できるか」という説明力を意味しています。のR-squaredは0.8と1に近いため、まずまずのモデルと言えるでしょう。
次に、exp_lの寄与は有意ではなかったため、exp_lをはずして、exp_mを説明することを試みます。


#exp_mを目的変数、exp_n, exp_lを説明変数として重回帰分析を行う

> summary(lm(exp_m~exp_n))

Call:
lm(formula = exp_m ~ exp_n)

Residuals:
    Min 1Q Median 3Q Max 
-10.069 -8.693 -6.009 8.438 19.493 

Coefficients:
                      Estimate  Std. Error    t value Pr(>|t|)    
(Intercept)      -9.7452   17.2506     -0.565   0.587616    
exp_n              0.6113   0.1197        5.107   0.000921 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1 

Residual standard error: 12.8 on 8 degrees of freedom
Multiple R-squared: 0.7653,Adjusted R-squared: 0.736 
F-statistic: 26.08 on 1 and 8 DF, p-value: 0.0009215 

#散布図に回帰直線を重ねて描写
> plot(exp_n, exp_m)
> abline(lm(exp_m~exp_n)

R-squredは0.06程度低下しましたが、依然として良いモデルと言えます。
実際の研究ではもっと多くの変数の組み合わせを検討してモデル探索を行い、決定係数をもとに独立変数の数を絞ります。

【参考文献】
山田剛史ほか『Rによるやさしい統計学』オーム社 2008 191 - 198pp

対応のあるt検定とANOVA


今回は、「対応のあるt検定」について考えます。対応のあるt 検定を意識したデータ構造は以下のようになります。下の図は、ある薬剤を投与前と投与後の体重の変化を示しています。検証したい命題は「ある薬剤を投与した前後で体重は変化するか」です。

対応のないt検定と比較する目的で、下の表を提示します。各群のデータは順番は入れ替えてあるものの、上の表と同じです。薬剤投与を受けた人と薬剤投与を受けなかった人は別の人を想定します。つまり、上の表の2倍の人数が下の表では動員されていることとなります。


これから、Rを用いて対応のある場合と対応のない場合で、薬剤投与による効果
> pre <- c(67, 70, 78, 65, 75, 77, 70, 76, 79, 83)
> post <- c(66, 68, 78, 63, 74, 76, 68, 75, 78, 82)

> negative <- c(78,67,75,65,70,77,70,83,79,76)
> positive <- c(68,66,78,75,82,78,76,63,68,74)

#ドットプロット
> source("http://aoki2.si.gunma-u.ac.jp/R/src/dot_plot.R", encoding="euc-jp")
#対応あり
> annot <- factor(c(rep("pre", 10), rep("post", 10), rep("negative", 10), rep("positive", 10)))
> dat <- c(pre, post, positive, negative)
> dot.plot(annot, dat)
#対応のあるt検定
> t.test(pre, post, paired=T)

 Paired t-test

data: pre and post 
t = 6, df = 9, p-value = 0.0002025
alternative hypothesis: true difference in means is not equal to 0 
95 percent confidence interval:
 0.7475686 1.6524314 
sample estimates:
mean of the differences 
                    1.2 

#対応のないt検定
> t.test(negative, positive, paired=F)

 Welch Two Sample t-test

data: negative and positive 
t = 0.4494, df = 17.91, p-value = 0.6585
alternative hypothesis: true difference in means is not equal to 0 
95 percent confidence interval:
 -4.411489 6.811489 
sample estimates:
mean of x mean of y 
     74.0 72.8 

驚くことに対応のあるt検定では有意差が検出されたのに、対応のないt検定では有意差が検出されませんでした。
この理由は、個人によるばらつきを対応のあるt検定によって制御できたことにあります。対応のないt検定の場合、個人差によるばらつきが残差に入ってしまうため、残差の分散が大きくなり、その結果薬剤の投与という要因による効果を検出するには至らなかったのです。これはまさにANOVAの考え方そのものです。というか、一般線形モデルの本質的な部分です。

対応のある一元配置分散分析を行うことで、薬剤と人という二つの要因による効果の大きさについて検証することができます。

> dat
 [1] 67 70 78 65 75 77 70 76 79 83 66 68 78 63 74 76 68 75 78 82


> drug <- factor(c(rep("negative", 10), rep("positive",10)))
> drug
 [1] negative negative negative negative negative negative negative negative
 [9] negative negative positive positive positive positive positive positive
[17] positive positive positive positive
Levels: negative positive

> person <- factor(rep(c("Hiroshi", "Takeshi", "Yamato", "Keita", "Tetsuya", "Shinta", "Yohei", "Daichi", "Yusuke", "Daisuke"),2))
> person 
[1] Hiroshi Takeshi Yamato Keita Tetsuya Shinta Yohei Daichi Yusuke 
[10] Daisuke Hiroshi Takeshi Yamato Keita Tetsuya Shinta Yohei Daichi 
[19] Yusuke Daisuke
10 Levels: Daichi Daisuke Hiroshi Keita Shinta Takeshi Tetsuya Yamato ... Yusuke

#drugとpersonの二つの要因を考慮してANOVAを行う。ただし、drugとpersonの間に交互作用はないものとする。
> summary(aov(dat~drug+person)) 
               Df  Sum Sq     Mean   Sq      F value    Pr(>F)    
drug         1           7.2              7.20           36.0    0.000202 ***
person      9        639.8            71.09         355.4    2.16e-10 ***
Residuals 9             1.8             0.20                     
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1 


#drugだけを要因として考えてANOVA
> summary(aov(dat~drug))
               Df  Sum Sq     Mean   Sq      F value    Pr(>F)   
drug         1           7.2              7.20        0.202     0.658
Residuals  18      641.6            35.64     


drugとpersonを考慮してANOVAを行うと残差(Residuals)の平方和(Mean Sq)が小さくなり、その結果F valueが大きくなることがわかります。F valueを求めるには、

F value = (drugのMean Sq) / (ResidualsのMean Sq)

です。
このように、対応のあるt検定はanovaにおいて、要因を追加することにより系統誤差を制御していることになるのです。その結果、説明できない誤差(すなわち残差)が小さくなるため、F値は大きくなり、その結果、小さなp値が出やすくなります。

以上のことから、実験結果に影響を及ぼす要因はできるだけ見いだしておいて、制御できるものは実験デザインによって制御することが大事であると言えます。

【参考文献】
山田剛史ほか『Rによるやさしい統計学』オーム社 2008 150-156, 175-179pp

フィッシャーの三原則

統計学の父であるフィシャー:Ronald A. Fisherは、農業試験の適切な実施のための方法論として実験計画法という学問分野を確立しました。
Fisherは局所管理、反復、無作為化の3つが大切であると述べています。これはフィッシャーの3原則と呼ばれ、農学以外の幅広い分野において利用されています。
以下に、肥料の種類による作物の生育具合の評価を目的とした農場試験を例に取って説明します。

1. 局所管理(小分け)の原則
実験計画の最も原始的な形態は以下のようなものです。複数水準の間の効果を比較したいのですが、同じ場所で異なる年度で調査を行おうとしています。これでは、年度ごとの気候の差が系統誤差として入ってきます。
そこで以下のように局所管理(小分け)すると、年度ごとの気候の差を調整することができます。


2. 繰り返し(反復)の原則
小分けをしただけではまだ問題が残ります。ある水準で生育がとても良かったときに、それが果たして偶然誤差によるものなのか、水準の違い(肥料の違い)によるものなのかがはっきりしません。この問題は水準ごとに実験を反復することで、解決することができます。同じ水準内で比較することにより、偶然誤差による差を調整することができるためです。

3. 無作為化の原則
2のように水準ごとに繰り返しを作ることで、偶然誤差と系統誤差(水準によるものとそうでないものを含む)に分解することが可能となりました。最後は、実験の割り付けを無作為化することが必要となります。2.のデザインでは、水はけは日当りなど、目的要因以外の要因が、一定の方向で偏りを持って実験結果に影響を与えている可能性が高くなるからです。つまり、水準以外の系統誤差が調整できていないのです。そこで、下の図のように無作為に実験を割り付けることにより、それらの系統誤差を調整することが可能となります。

以上、フィッシャーの3原則でした。
基本的な発想は、「目的となる要因以外からの影響が極力排除すること」です。肥料以外の要因は一定になるように努力するとともに、もしそれを制御しきれないのならば、せめて肥料以外の要因が実験結果に偏って現れないようにデータ収集することが大事なのです。

この発想は臨床試験や生物学実験においても大切な発想であると思います。


【参考文献】
栗原 伸一『入門統計学』Ohmsha, 2011, 88-89, 130-138pp


二群比較と回帰分析の関係


今回は二群比較と回帰分析の関係について考えたいと思います。
前回のブログでは、ANOVAと二群比較が共に「目的とする効果による変動が誤差による変動に対して有意に大きいか」という発想を根底に持つという意味で共通しているのだという議論を行いました。
実は、回帰分析と二群比較も同様の議論が可能です。
二群比較と単回帰分析は本質的に同じことをしているのです!
単回帰分析モデルの一般式は
y = βx + α + ε
と表されます。
これは、まさに目的の効果と誤差を分離して、説明変数を説明しようとしている式です。
これを前提にして、二群比較のそれぞれの群に0と1のダミー変数を与えて、回帰分析を行うと、通常のt検定をと同じp値が得られます。
以下では、Rを用いて検証を行いました。

> cityA <- c(178, 182, 181, 179, 178, 182, 181, 179, 173, 187, 170, 190)
> cityB <- c(168, 172, 174, 166, 169, 171, 165, 175, 162, 178, 164, 176)

> dat <- c(cityA, cityB)
> dat
 [1] 178 182 181 179 178 182 181 179 173 187 170 190 168 172 174 166 169 171 165
[20] 175 162 178 164 176

#ダミー変数を用いてcityAに0を、cityBに1を与える

> city <- c(rep(0,12), rep(1,12))
> city
 [1] 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1

#この段階で散布図を描写
> plot(dat~city)
#回帰分析
> summary(lm(dat~city))

Call:
lm(formula = dat ~ city)

Residuals:
   Min     1Q Median     3Q    Max 
 -10.0   -2.5    0.0    2.5   10.0 

Coefficients:
            Estimate Std. Error t value Pr(>|t|)    
(Intercept)   180.00       1.52 118.416  < 2e-16 ***
city          -10.00       2.15  -4.652 0.000123 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1 

Residual standard error: 5.266 on 22 degrees of freedom
Multiple R-squared: 0.4959, Adjusted R-squared: 0.473 
F-statistic: 21.64 on 1 and 22 DF,  p-value: 0.0001228 


#通常の2群間比較をt検定にて行う
> t.test(cityA, cityB, var.equal=F)

Welch Two Sample t-test

data:  cityA and cityB 
t = 4.6518, df = 21.96, p-value = 0.0001233
alternative hypothesis: true difference in means is not equal to 0 
95 percent confidence interval:
  5.541324 14.458676 
sample estimates:
mean of x mean of y 
      180       170 

#散布図の上に回帰直線を描写する
> plot(city, dat)
> abline(lm(dat~city))
大学の一般教養の講義や導入書では、anovaやtテスト、回帰分析を別個の物として扱うに留まっていることが多いように感じます。しかし、一般線形モデルを意識しながらこれらを眺めると、「目的の効果と誤差を分離する」という共通原理が浮き彫りになってきます。

Peter Dalgaard『Rによる医療統計学』2007 丸善株式会社  92 - 96pp

二群比較とANOVAの関係

今回は、平均値の二群比較が、対応の無い2群の一元配置分散分析を行うことに等しいことを直感的に理解することを目指します。


今、CityAとCityBに住んでいる住人をそれぞれの群から無作為に6人だけ選出して身長を測定したとします。それが以下のデータです。
このデータに対して対応の無い2群の一元配置分散分析を行います。


分散分析とは総変動を以下のように

総変動 = 目的要因変動 + 誤差変動
と分けることが発想の基盤となります。これにしたがって、以下の図のように目的要因変動(都市による変動)と誤差による変動を計算します。


総変動を分解した結果が以下のようになります。群間変動というのは目的要因変動(都市による変動)のことであり、群変動とは誤差による変動のことを指します。


これらから、各偏差平方を計算すると以下のようになります。
分散分析とは、目的となる要因効果(群間変動)の分散が、誤差効果(標本間変動をのぞいた群内変動)の分散に比べて有意に大きいかを検定する統計手法です。これを行うにはこれら二つの比を取れば良いのです。そしてこの比は等分散の検定の時に用いた、F値です。自由度はそれぞれの自由度とします。

今回のケースで実際に計算してみると、

F = 300 / 6 = 50

となります。
自由度v1 = 1, v2 = 10の下、上側確率が5%になるF値は、,F分布表を参照すると4.96となります。
そのため、「今回のケースは都市による変動が誤差による変動を危険率5%で有意に上回る」と言うことができます。

一方、今回のケースにStuden t検定を行うとどうなるでしょうか。個々から下はRを用いて計算を行います。

$ R
> cityA <- c(178, 182, 181, 179, 178, 182)
> cityB <- c(168, 172, 174, 166, 169, 171)
> t.test(cityA, cityB, var.equal=T)

Two Sample t-test

data:  cityA and cityB 
t = 7.0711, df = 10, p-value = 3.411e-05
alternative hypothesis: true difference in means is not equal to 0 
95 percent confidence interval:
  6.848936 13.151064 
sample estimates:
mean of x mean of y 
      180       170 

p< 0.05なので、二群の平均値の間には有意な差があると言うことができます。
ところで、t値は7.0711と求まりました。
実はこのt値を2乗してみると面白い結果を得ることができます。

> 7.0711 * 7.0711
[1] 50.00046

なんと驚いたことに、先ほど計算したF値とStudent t testで計算したt値の二乗が一致するではありませんか。これはただの偶然ではないのです。
一般に、平均値の二群比較でもとめられるt値の二乗は、対応の無い2群の一元配置分散分析を行うF値に等しいのです。

このことから、tテストを行うということはANOVAを特定下で行うことに等しいということができます。

この話題は、結局平均値の二群比較とANOVAと回帰分析を巻き込んで、一般化線形モデルというトッピックに発展するようです。

まだ勉強の途中でよく理解できていないので、あまり細かいことは良く理解できていません。しかし、現状理解できているのは、「見たい要因による効果」と「偶然による誤差」を一次結合の形式で分離することができるというモデル(信念)を頭において、これらの理論は構築されているということです。
非線形であった場合、例えば誤差がある値を超えてきた場合に、見たい要因の変動にもとても大きな(小さな)な影響を与えるようなことが起きると思われます(一例ですが)。非線形の場合は、さまざまな要因間が絡み合っていると考えるはずです。要するに、「世の中、物事の足し算でできているような単純なものではない」とすることではないでしょうか。

少し、哲学的になってきてしまいましたが、現状私が理解できている(しているつもり)の範囲を書きました。

【参考文献】

栗原 伸一『入門統計学』Ohmsha, 2011, 88-89, 130-138pp


Rを用いた単回帰分析の基本

ある試薬を培養細胞に添加したときのある遺伝子の発現量を制御するための実験を行った。実験結果は以下の通りである。このデータを用いて単回帰分析を行う。


以下解析。

#Rを起動
$ R

#データの入力
x <- c(0.1, 0.2,0.3,0.4,0.5,0.6)
y<-c(3.1,3.8,5.7,6.7,7.5,9.3)
dat <- data.frame(x, y)

#データの確認
dat

    x   y
1 0.1 3.1
2 0.2 3.8
3 0.3 5.7
4 0.4 6.7
5 0.5 7.5
6 0.6 9.3

#データの描写
png("dat1.png"); plot(dat, xlab="reagent dose(ug)", ylab="gene expresion"); dev.off();
#回帰分析
model <- lm(y~x, data=dat)

#回帰分析結果の要約表示
summary(model)

Call:
lm(formula = y ~ x, data = dat)

Residuals:  #各残差
            1             2             3            4              5             6 
 0.16190 -0.36952  0.29905  0.06762 -0.36381  0.20476 

Coefficients:
                 Estimate     Std. Error    t value    Pr(>|t|)            #推定値
(Intercept)   1.7067        0.3056      5.585     0.00504 **     #定数項(β0)
x                12.3143       0.7847    15.693     9.63e-05 ***  #回帰係数(β1)
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1 

Residual standard error: 0.3283 on 4 degrees of freedom  #残差の標準誤差
Multiple R-squared: 0.984, Adjusted R-squared:  0.98 #寄与率、調整済寄与率
F-statistic: 246.3 on 1 and 4 DF,  p-value: 9.632e-05        #F0値、p値

#回帰係数の95%信頼区間を算出

confint(model, level=0.95)

                          2.5 %      97.5 %
(Intercept)  0.8581746    2.555159    #β0の95%信頼区間の下限と上限
x              10.1355593   14.493012   #β1の95%信頼区間の下限と上限

#実験データの散布図と回帰直線の描写

png("dat2.png");
plot(dat, xlab="reagent dose(ug)", ylab="gene expresion"); 
abline(model, col="red")
dev.off();
【参考文献】
辻谷 将明、 和田 武夫『Rで学ぶ確率・統計』共立出版 2012 122 -136 pp.


スパコンにまつわる統計

スパコンの計算速度を基準としたランキングは、世間をにぎわせています。
このランキングは、Top500(http://www.top500.org/)にて閲覧、データダウンロードが可能です。

今回はこのサイトで実装されている解析機能を利用してスパコンに関する様々な統計(http://www.top500.org/statistics/list/)について見てみたいと思います。


/*----------------まずは2012年度のデータについて-----------------*/
http://www.top500.org/statistics/list/
#1.スパコンのベンダーについて(2012年)
巨人IBMがやはり最強といったところでしょうか。Fujitsu応援しています。
#2.OSについて(2012年)
Linuxが90%以上の圧倒的なシェアを占めています。Linuxはソースコードがオープンであるために、細かいチューニングが可能であり、ハイエンドユーザーにとって理想的なOSであるからだと考えられます。
#3.国別シェア
国別シェアでは予想されるようにアメリカが半分を占めています。中国がその次に来ていて日本は世界第3位です。GDPの順番を見ているような気持ちになります。


/*----------------各種データの経時的変化について(Development Over Time)-----------------*/

#4.ベンダーシェアの経時的変化
2008年頃からkaraIBMとHPが急速にシェアをのばしていることがわかります。Cray Inc.やSGIは一方でシェアを奪われてしまったようです。

#5.OSのシェアについて
ここ20年間の間でスパコンのOSはUNIX系OS(Unix, BSD, Linux)が圧倒的な地位を占めてきたことがわかります。その中でも面白いのがLinuxの急速な拡大です。Linuxは1991年に開発が開始されたとされていますが、それから10年もしないうちにスパコンで使用されるようになり、現在では90%を超えるスパコンに使用されていることがわかります。

縦軸のログを取る意味の考察


単位が同じで異なる種類の変数を一つの折れ線グラフの中にプロットすることがあります。このとき、どうしても平均して大きい値を取る変数の方が大きな変化を示しているように錯覚しています。このようなことを防ぐには、縦軸のログを取ると良いです。

以下のグラフでは、upper, lowerのいずれも2倍、半分、2倍、半分、と変化しています。ログを取らないと、upperの方が大きく変化しているように見えてしまいます。そこで、ログを取ってみると、見事にそれぞれの群の変化が同じであることが可視化することが可能です。

#データの作成
upper <- rep(c(100,200), 10)
lower <- rep(c(10, 20), 10)

##データをプロット(縦軸は通常のスケール)##
plot(upper, type = "l", ylim=c(0, 250), ylab = "Numbers")
lines(lower)
##データをプロット((縦軸はログを取る)##
plot(log(upper), type = "l", ylim = c(1,6), ylab = "Log numbers")
lines(log(lower))


 縦軸のは通常のスケール


 縦軸のログを取ったグラフ
【参考文献】 Michael JC 著 野間口謙太郎他訳『統計学:Rを用いた入門書』2008 共立出33 - 34pp

Rによる中心値の計算 -関数定義の研究-

今回は、Rで中心値(算術平均、中央値)の計算を行う方法について検討したいと思います。Rには使い勝手の良い組み込み関数が存在しますが、アルゴリズムを知る意味で、ここは敢て関数を定義して使用します。

############関数の定義#############

##算術平均を計算する関数##
arithmetic.mean <- function(x) {
sum(x)/length(x)
}

##中央値を計算する関数##
mymedian <- function(x){
odd.even <- length(x)%%2    #要素数を2で割った時の余りを計算
    if(odd.even == 0)               #要素数が偶数のとき
        (sort(x)[length(x)/2] + sort(x)[length(x)/2 + 1])/2    #中央にある2値の算術平均を計算
    else                                    #要素数が奇数のとき
        sort(x)[ceiling(length(x)/2)] #ceiling(x)はx以上で最小の整数を返す
}

############関数のテスト#############

#データの作成
odd <- c(1,2,3,4,5,6,7) #奇数
even <- c (1,2,3,4,5,6) #偶数

##算術平均の計算##
arithmetic.mean(odd)

[1] 4
#Rの組み込み関数による計算
mean(odd)
[1] 4

##中央値の計算##
#要素数が偶数のデータ
mymedian(odd)
[1] 4
median(odd)  #組み込み関数medianで計算
[1] 4
#要素数がのデータ
mymedian(even)
[1] 3.5
median(even)  #組み込み関数medianで計算
[1] 3.5

【参考文献】
Michael JC 著 野間口謙太郎他訳『統計学:Rを用いた入門書』2008 共立出版  28 - 32pp

正規分布への当てはまりの良さ

データが正規分布にどの程度当てはまっているかを調べるには、
(1)normal q-q plotにより、定性的に評価
(2)Kolmogorov-Smirnov test(K-S検定)やShapiro-Wilk test(S-W検定)を用いて、p値を指標に評価
の二つの方法があります。

今回はこれらの方法について取り扱いと思います。


(1)normal q-q plotにより、定性的に評価
normal q-q plotととは、標準正規分布とデータの分位点との関係を図示したもので,これが,直線上に 乗っているとデータが正規分布によくあてはまっていることがわかります。

以下には、1)正規分布 2)ポアソン分布3)ベータ分布4)カイ二乗分布
を母集団として、乱数を発生させて、正規分布にどの程度当てはまるかを定性的に評価したいと思います。

##########################################################################
# 1)正規分布
dat1 <- rnorm(1000, mean=10, sd=2)
png("dat1.png")
#x に対する期待正規ランクスコアをプロットする
qqnorm(dat1)
#プロットにデータの上四分位点と下四分位点を結ぶ直線を描く
qqline(dat1, col="red")
dev.off()


# 2)ポアソン分布
dat2 <- rpois(n=1000, lambda=5)
png("dat2.png")
#x に対する期待正規ランクスコアをプロットする
qqnorm(dat2)
#プロットにデータの上四分位点と下四分位点を結ぶ直線を描く
qqline(dat2, col="red")
dev.off()

# 3)ベータ分布
dat3 <- rbeta(n=1000, shape1=5, shape2=3)
png("dat3.png")
#x に対する期待正規ランクスコアをプロットする
qqnorm(dat3)
#プロットにデータの上四分位点と下四分位点を結ぶ直線を描く
qqline(dat3, col="red")
dev.off()

# 4)カイ二乗分布
dat4 <- rchisq(n=1000, df=11, ncp=0)
png("dat4.png")
#x に対する期待正規ランクスコアをプロットする
qqnorm(dat4)
#プロットにデータの上四分位点と下四分位点を結ぶ直線を描く
qqline(dat4, col="red")
dev.off()

##########################################################################

(2) K-S検定 S-W検定
##########################################################################

### 1)正規分布を例に少しオブジェクトの構造を解析する
#K-S検定はks.test()を使用
> ks.test(dat1, "pnorm", mean=mean(dat1), sd=sqrt(var(dat1)))

One-sample Kolmogorov-Smirnov test

data:  dat1 
D = 0.0597, p-value = 0.8681
alternative hypothesis: two-sided 

> summary(ks.test(dat1, "pnorm", mean=mean(dat1), sd=sqrt(var(dat1))))
            Length Class  Mode     
statistic   1      -none- numeric  
p.value     1      -none- numeric  
alternative 1      -none- character
method      1      -none- character
data.name   1      -none- character

#p値を単独で取得できそう!
> (ks.test(dat1, "pnorm", mean=mean(dat1), sd=sqrt(var(dat1))))$p.value
[1] 0.8681218 #キター!!

###以下、各データに対して、K-S検定及びS-W検定を行う
#S-W検定はshapiro.test()を使用
> shapiro.test(dat1)

Shapiro-Wilk normality test

data:  dat1 
W = 0.9869, p-value = 0.434

> (shapiro.test(dat1))$p.value
[1] 0.4339936

###それでは各分布のサンプルについて検定を行います
# 1)正規分布
(ks.test(dat4, "pnorm", mean=mean(dat4), sd=sqrt(var(dat4))))$p.value
(shapiro.test(dat4))$p.value
> (ks.test(dat1, "pnorm", mean=mean(dat1), sd=sqrt(var(dat1))))$p.value
[1] 0.8681218
> (shapiro.test(dat1))$p.value
[1] 0.4339936

# 2)ポアソン分布
> (ks.test(dat2, "pnorm", mean=mean(dat2), sd=sqrt(var(dat2))))$p.value
[1] 0.07005836
> (shapiro.test(dat2))$p.value
[1] 0.00998934

# 3)ベータ分布
> (ks.test(dat3, "pnorm", mean=mean(dat3), sd=sqrt(var(dat3))))$p.value
[1] 0.5573208
> (shapiro.test(dat3))$p.value
[1] 0.1299853


# 4)カイ二乗分布
> (ks.test(dat4, "pnorm", mean=mean(dat4), sd=sqrt(var(dat4))))$p.value
[1] 0.0003856757
> (shapiro.test(dat4))$p.value
[1] 1.577593e-17
##########################################################################

(1)の方法は直感的でわかりやすいですね。(2)の方法は、例数が少なかったり、母集団の分布が正規分布に似ていたりすると、なかなかp値は小さくならないようです。p値が0.05を下回らないからといって、母集団の分布が正規分布であるとはだれも保証はできません。

【参考文献】
・統計学の基礎
・R - Source 正規性の検定


統計局ホームページ

国勢調査の結果など国が持っているデータにWeb上でアクセスする方法がわかりました。
統計局ホームページに行けばよいのです。
http://www.stat.go.jp/

総務省統計局、
政策統括官(統計基準担当)
統計研修所
の共同運営による統計専門サイトだそうです。

『国の統計の中枢機関として、私たちは、国勢調査を始め国勢の基本に関する統計の企画・作成・提供、国の統計全体の企画及び横断的な調整、また、国及び地方公共団体の統計職員に専門的な研修を行っています』だそうです。

統計や疫学が大好きな人間としては、とても興味深いですね。

手っ取り早く遊ぶには、
"日本の統計" http://www.stat.go.jp/data/nihon/index.htm
 にいくと良いと思います。

この中でも、2012年度版の"第2 人口・世帯" http://www.stat.go.jp/data/nihon/02.htm
の"年齢各歳別人口"のデータをダウンロードしてデータを可視化してみました。

これがダウンロードしたデータです。


このデータの中で、年齢と総数についての列を切り出して、年齢0 - 100の区間で棒グラフを作成したのが下です。


とても考えさせる図ですね。60代前半のベビーブームとそのジュニア世代にピークが見られるのがなんとも興味深いですね。そして、65歳以上の人口もかなりの割合を占めていることがわかります。

何も難しい統計手法を用いなくても、全体のデータの分布をしっかりと可視化することで、様々な情報を得ることができるのですね。

他にも細かい統計データが満載で、EXELデータも大量に手に入りますので、皆さんもぜひ、日本の将来を考える意味でもいろいろと眺めてみてください。


私のブログの人気記事ランキング

私は、このブログの中で比較的広範囲のトピックについて記事を書いています。

ブログ開設以来、アクセス数の多かった順に棒グラフ(Bloggerを触れば簡単にできます)を作成すると、以下のようになりました。


slaxやubuntuの基本的な設定に関する記事がとてもアクセスが多かったことがわかります。
大変興味深い結果だと思います。
私自身は、生物系の学問に興味が有り、必要に応じてこれらのトピックを扱っている訳ですが、検索エンジンを介すると、ubuntuなどのコモンな言葉がヒットしてくるようです。

シンプルな棒グラフですが、大変示唆に富んでいるデータなので記事に
しました(^^)

症例対照研究の統計学的バックグラウンドの詳細

今回は症例対照研究の統計学的なバックグランドについて考えたいと思います。
症例対照研究 case-control study / retrospective study、ある特定疾患の患者群と非患者群の2集団について、個人の過去の記録から、ある要因に曝露していたか否かを調べ、因果関係を研究するスタイルです。

症例対照研究では、現に存在する患者群と対照群を慎重に選定さえすれば、情報はすべて過去の記録を調べればよいので、割に簡単に行うことができる研究方法です。

症例対照研究では、オッズ比(図2のad/bc)から近似的に相対危険度を推定し、その大きさで、因果的関連のある要因を選び出すことが多いです。

オッズ比を用いて相対危険度を推定することに関して今回は少し深く扱います。

私たちが疫学を用いて知りたいことは本来、要因の相対危険度です。相対危険度とは図1のA/(A+B)とC/(C+D)の比です。相対危険度とはコホート研究(prospective study)を行うことで、下の表が決定されてはじめて求めることができます。
もしも、症例対照研究において、図2のa/(a+b)とc/(c+d)の比を求めようとするものなら大間違いです。なぜなら、要因の有無別に分けたa + bとc + dは意味を持たないからです。a+b, c+dは患者群と対照群を同じ割合で代表しているわけではないからです。

#図1 コホート研究の分割表


#図2 症例対照研究の分割表


それでは、症例対照研究で要因と結果の因果関係をするうえで有用なパラメータは何なのでしょうか。
実はこれがオッズ比です。Q1およびQ2 を未知の標本の抽出率として(症例対照研究は未知のコホートを想定している)、

a + c = Q1(A + C)より
a = Q1A, c = Q1C

b + d = Q2(B + D)より
b =Q2B, d = Q2D
として
想定する母集団のコホートのオッズ比は、
AD/BC = (a/Q1)(d/Q2)/(c/Q1)(b/Q2) = ad/bc
となる。
この結果から、症例対照研究において、サンプルのオッズ比を計算することは、母集団のオッズ比を反映することになる。

ところで、私たちの本当の目的は相対危険度を求めることである。
冒頭で挙げた『症例対照研究では、オッズ比(図2のad/bc)から近似的に相対危険度を推定し、その大きさで、因果的関連のある要因を選び出すことが多いです。』という一文の本質に迫りたいと思います。
オッズ比から近似的に相対危険度を推定できるのは、一般に罹患率や死亡率などの小さい発生率のものに限られます。
これらの率では、図1において
A + B ~= B
C + D ~= D
と近似できるのです。なぜなら、A<<B, C<<Dだからです。
このとき、
{ A/(A+B)} / {C/(C+D)} ~= {A/B} / {C/D} = AD/BC = ad/bc
となります。
以上のことから、

『症例対照研究では、オッズ比(図2のad/bc)から近似的に相対危険度を推定し、その大きさで、因果的関連のある要因を選び出すことが多いです。』

と言うことができます。


################### 以下実例  #####################
新版 医学への統計学  p136より

「女性について肺癌患者108名、対照群108名を選出し、喫煙歴について調査してみると、下の表が得られた。相対危険度を推定し、その有意性の検定、ならびに95%信頼区間を求めよ」


この問題を考える上で大切なことは、下の(1)式で示すχ値の二乗値が標準正規分布に従うことです。

具体的な計算は以下のようになります。以下の式(4)は、,Miettienのの検定に基づく信頼区間と呼ばれています。

計算の結果、危険率5%の条件下でオッズ比は1よりも有意に大きいことがわかります。また、オッズ比の95%信頼区間は、1.19 〜 3.54 となります。有意差検定の結果を反映して、信頼区間には1が含まれていません。
一般に肺癌の罹患率は小さいため、オッズ比 2.05(1.19,3.54)は近似的に喫煙の肺癌罹患に関しての相対危険度と考えることができます。

【参考文献】
古川俊之 丹後俊郎『医学への統計学』朝倉書店 1993 133 - 136pp