メモリとセグメント

プログラムはメモリをセグメントよばれる領域に分割してデータを格納しています。

セグメントには、

○スタックセグメント
ローカル変数、引数が収める

○データセグメント
グローバル変数を収める

○テキストセグメント(コードセグメント)
プログラムのコード部分を収める

の三つの種類があります。

下のプログラムは三つのセグメントのアドレスの具体例を表示させるものです。


#include<stdio.h>

int A,B;

int main(void)
{
        int a,b;
        printf("###ローカル変数はスタックセグメント格納###\n");
        printf("a       = %p\n", &a);
        printf("b       = %p\n", &b);
        printf("###グローバル変数はデータセグメント格納###\n");
        printf("A       = %p\n", &A);
        printf("B       = %p\n", &B);
        printf("###関数はテキストセグメント(コードセグメントへ格納)###\n");
        printf("printf  = %p\n", printf);
        printf("main    = %p\n", main);
        return 0;
}

実行例

###ローカル変数はスタックセグメント格納###
a = 0xbf832c3c
b = 0xbf832c38
###グローバル変数はデータセグメント格納###
A = 0x804a020
B = 0x804a024
###関数はテキストセグメント(コードセグメントへ格納)###
printf  = 0x8048318
main    = 0x80483f4

スタックオーバーフローを出す


関数を呼び出す度に、メモリ上のスタック領域にはローカル変数とリターンアドレスが格納される。
下のプログラムは、関数functionの中で1000個の要素を持つ配列を確保した後、再度自らを呼び出してまた1000個の要素を持つ配列を確保する関数です。
無限に配列が作成されるためスタック領域は容量オーバーをおこしてしまします。このことを「スタックオーバーフロー」と呼びます。


#include<stdio.h>

void function()
{
        char str[1000];
        printf("%p\n", str);
        function();
}

int main(void)
{
        function();
        return 0;
}


実行例

0xbff405b4
0xbff401a4
0xbff3fd94
0xbff3f984
0xbff3f574
0xbff3f164
0xbff3ed54
0xbff3e944
0xbff3e534
0xbff3e124
0xbff3dd14
0xbff3d904

・・・・以下続く・・・・


グローバル変数とローカル変数


グローバル変数とローカル変数のメモリ領域の違い

グローバル変数(var1_global, var2_global)とローカル変数(var_local)を宣言して、各々の


#include<stdio.h>

int var_global;

void funcA(void)
{
        int var_local2;
        printf("var_local2  : %p\n\n", &var_local2);
        return;
}  


int main(void)
{
        int var_local1;
        printf("var_global : %p\n\n", &var_global);
        printf("var_local1  : %p\n\n", &var_local1);
        funcA();
        return 0;
}

実行結果

var_global : 0x804a01c

var_local1  : 0xbfc48efc

var_local2  : 0xbfc48ecc


ローカル変数とスタック


C言語において、ローカル変数はスタックと呼ばれるメモリの領域に記憶されるようです。
スタックといえば情報科学でよくでてくるLIFO(Last In First Out)の形式で要素の出入りが管理される処理形態ですね。

下の例では、main関数から呼び出されたfuncAの中でvar2=100が宣言しています。
funcBでは、初期化をせずにvar3を宣言しています。そのため、var2の内容がスタックから開放されずに、var3の内容になってしまいました。

#include<stdio.h>

void funcA(void)
{
        int var2=100;
        printf("var2 = %d in funcA\n\n",var2);
        return;
}
void funcB(void)
{
        int var3;
        printf("var3 = %d in funcB\n\n",var3);
        return;
}

int main(void)
{
        int var1=777;
        printf("var1 = %d in main function\n\n",var1);
        funcA();
        funcB();

        return 0;
}


実行結果

var1 = 777 in main function

var2 = 100 in funcA

var3 = 100 in funcB

RNAseqの基本的な解析例

RNAseqの基本的な解析についてまとめてみました。
データはNBPSeqというパッケージに付属のarabを用いました。
これはシロイヌナズナ(Arabidopsis)のmutantとコントロールの二群から各々3つずつサンプリングされ、Illumina Genome Analyzer(http://www.illumina.com)によりシーケンスされたものです。

###データの読み込みと簡単な評価##

#NBPSeqをインストール&ロード
source("http://bioconductor.org/biocLite.R")
biocLite("NBPSeq")
library(NBPSeq)

#arabオブジェクトを生成
data(arab)

#arabの中身を頭出し
> head(arab)
mock1 mock2 mock3 hrcc1 hrcc2 hrcc3
AT1G01010 35 77 40 46 64 60
AT1G01020 43 45 32 43 39 49
AT1G01030 16 24 26 27 35 20
AT1G01040 72 43 64 66 25 90
AT1G01050 49 78 90 67 45 60
AT1G01060 0 15 2 0 21 8
#NGSのデータ特有の整数値が格納されていることが確認できる。

#arabオブジェクトの構造(各カラムのモード等)を表示
> str(arab)
int [1:26222, 1:6] 35 43 16 72 49 0 16 170 291 113 ...
- attr(*, "dimnames")=List of 2
..$ : chr [1:26222] "AT1G01010" "AT1G01020" "AT1G01030" "AT1G01040" ...
..$ : chr [1:6] "mock1" "mock2" "mock3" "hrcc1" ...


####データの可視化により定性的な評価を行う###

#サンプル間のすべての組み合わせに対してscatter plotを行い、technical duplicateとbiological duplicateのばらつきを評価する。
pairs(arab, log="xy", pch=16, cex=.3)


#hとmの各々について行の平均値を計算する
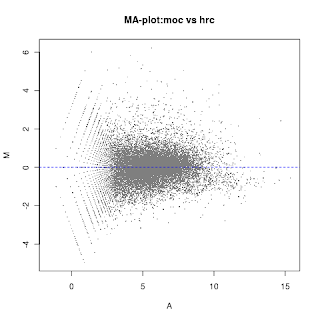
mean_m <- apply(arab, 1, function(x){mean(x[1:3])}) mean_h <- apply(arab, 1, function(x){mean(x[4:6])}) #MAプロットを行うために、M (log fold-change)とA (log intensity)を求める。 M <- log2(mean_h) - log2(mean_m) A <- 1/2 * (log2(mean_h) + log2(mean_m)) #MAプロットを行う plot(A, M, pch=16, cex=0.3, col="gray50",main="MA-plot:moc vs hrc) #M=0の高さに水平線を引く。 abline(h=0, col=4, lty=2)


###5倍以上の発現変動があった遺伝子をピックアップする。###

#これまでの計算結果をひとつのテーブルにまとめる
arab_summary <- data.frame(arab, mean_m, mean_h, M, A) #各行で発現変動があったかどうかを調べて二値で表す。(RPKMなどの手法で正規化を行っていない生データに対して解析を行うのは乱暴であるが。。) > head(M >= log2(5))
AT1G01010 AT1G01020 AT1G01030 AT1G01040 AT1G01050 AT1G01060
FALSE FALSE FALSE FALSE FALSE FALSE
#5倍以上の発現変動があった遺伝子を抽出し、新たなテーブルを作成
five_fold <- subset(arab_summary, arab_summary$M >= log2(5))

#MA-plotを描写して、5倍異常の発現変動があった遺伝子を赤くマーキングする
plot(arab_summary$A, arab_summary$M, pch=16, cex=0.3, col="gray50")
points(five_fold$A, five_fold$M, col="red", pch=16, cex=0.4)


#倍数変化の手法だと、発現値の低い遺伝子(ばらつきの大きな傾向にあります)にたくさんの偽陽性が含まれて、
#発現値の高い遺伝子(ばらつきが小さい傾向にあります)に偽陰性がたくさんふくまれてしまいます。
#しっかりデータ全体にたいして正規化を行った後、t-testなどでp値を用いた検定を行い、その両者の共通項を探しにいくのが無難かと思われます。